NOTIZIA IN BREVE
NanoTS analizza letture lunghe di RNA ottenute con nanopore per ricostruire varianti a singola base, nonostante gli errori del sequenziamento.
Su varianti con almeno cinque letture di supporto, gli autori riportano punteggi F1 oltre 0,980 per RNA diretto e 0,966 per cDNA, nei dati studiati.
Il metodo ha anche riconosciuto varianti patogene in linee cellulari di pazienti, ma non è stato dimostrato un beneficio diagnostico in ospedale.
PERCHÉ CONTA
L'analisi dell'RNA mostra quali geni sono espressi e come vengono composte le loro trascrizioni, ma i dati nanopore possono avere errori che rendono difficile distinguere una variante reale da un segnale tecnico.
Poter riconoscere meglio la variante e la sua espressione nella stessa analisi potrebbe aiutare la ricerca sulle malattie rare, purché la prestazione sia confermata in workflow diagnostici indipendenti.
CHE COSA È ORA POSSIBILE
Before: RNA read errors and allele imbalance often disrupted calling. Now: a new method improves benchmark F1 and demonstrates pathogenic variant recovery in cultured patient-derived cells.
COSA LO HA RESO POSSIBILE
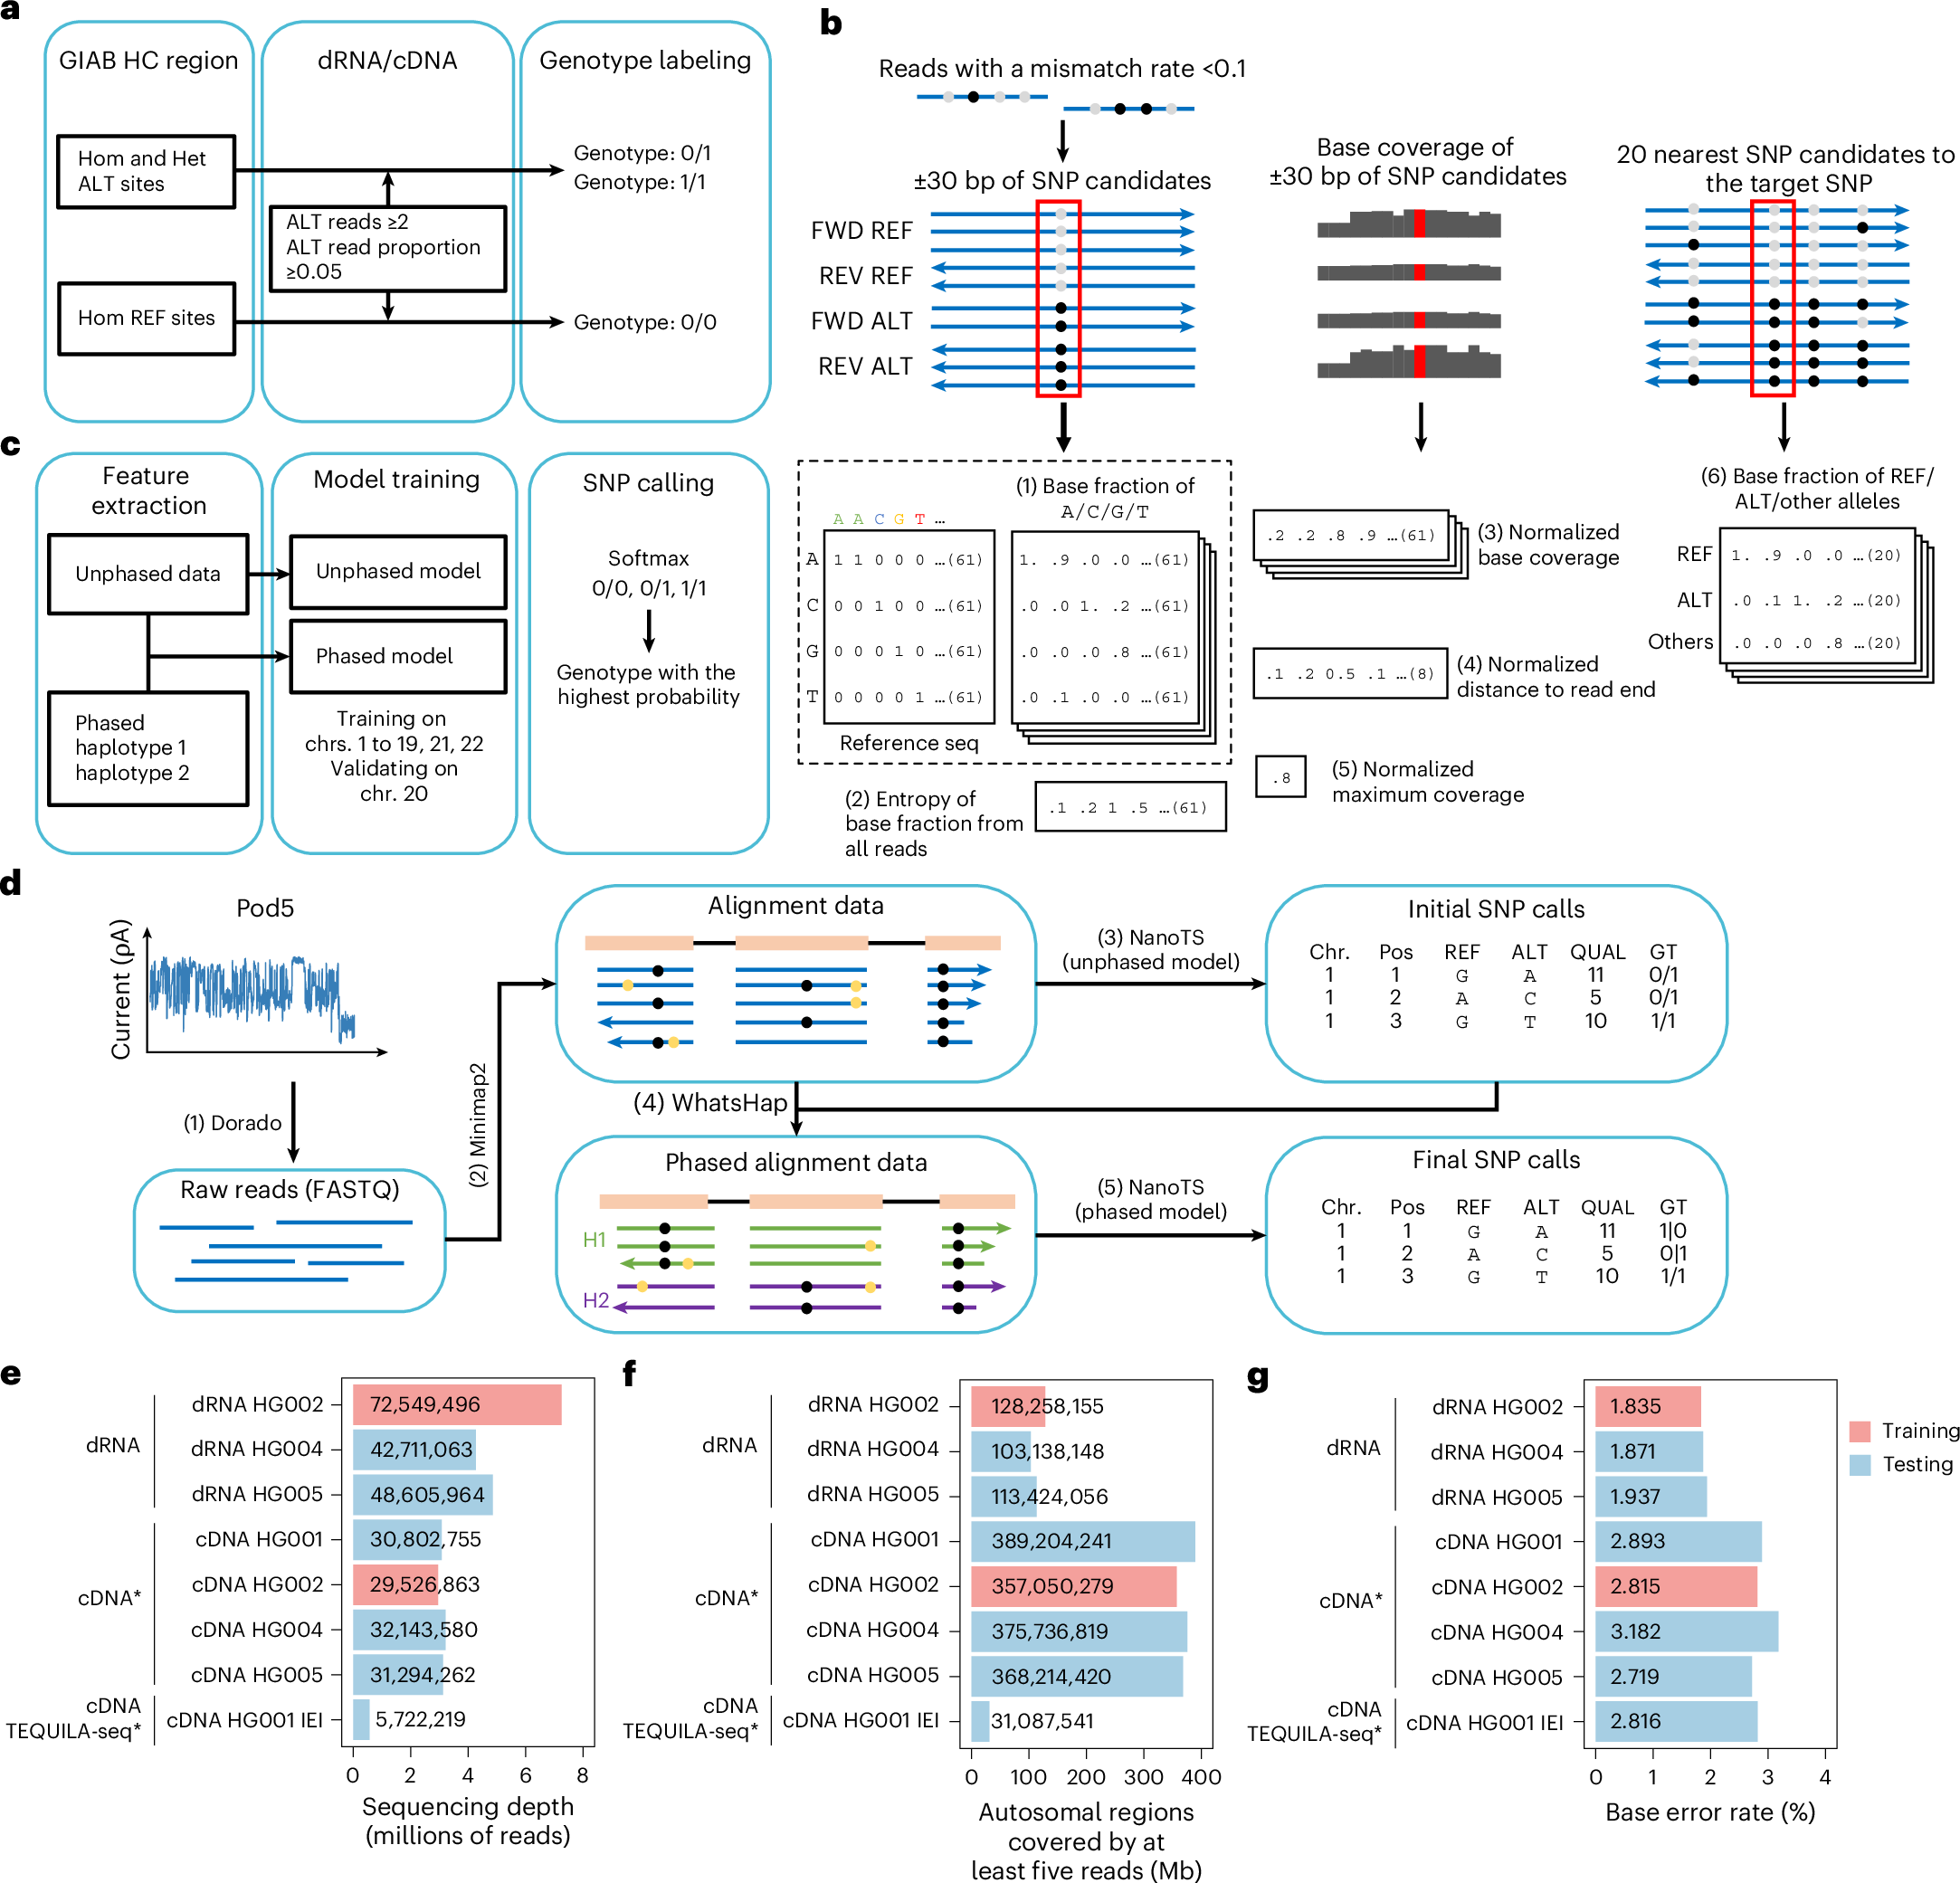
NanoTS combina segnali locali delle sequenze, copertura e posizione della lettura con informazioni di fase: raggruppa cioè le letture in base all'allele e all'aplotipo.
Il modello viene addestrato con dati di riferimento ad alta confidenza Genome in a Bottle e confrontato con strumenti specializzati per RNA a lettura lunga.
LA STORIA
Un sequenziatore nanopore può leggere molecole di RNA molto lunghe, seguendo varianti e forme alternative dello stesso trascritto. Ma errori di lettura e grandi differenze fra i livelli di espressione dei geni complicano l'identificazione affidabile di singole basi diverse dal riferimento. Un gruppo del Children's Hospital of Philadelphia ha sviluppato NanoTS per affrontare proprio questo problema. Il metodo è stato pubblicato su Nature Methods il 22 settembre 2026 e verificato su dati di riferimento e linee cellulari legate a malattie genetiche.
NanoTS usa una rete neurale che non osserva soltanto quale base appare in una posizione. Considera la frazione di letture per i diversi nucleotidi, l'orientamento delle sequenze, la distanza dagli estremi e altri segnali di qualità. Un secondo passaggio incorpora gli aplotipi, ricostruendo quali varianti compaiono insieme sulla stessa copia cromosomica. Questo aiuta in particolare dove uno dei due alleli viene espresso molto meno dell'altro e i metodi standard rischiano di perderlo.
I ricercatori hanno addestrato il metodo usando il campione di riferimento HG002 e le varianti curate del progetto Genome in a Bottle. Nei confronti su letture di RNA diretto e cDNA, per varianti con almeno cinque letture di supporto, NanoTS ha raggiunto punteggi F1 superiori a 0,980 e 0,966 rispettivamente. Il punteggio F1 riassume precisione e capacità di recuperare le varianti del set di riferimento. Non significa un'accuratezza del 98% per ogni campione clinico, né la stessa prestazione in zone con copertura insufficiente.
Il lavoro include anche un passaggio biologico oltre il benchmark. Campioni di fibroblasti derivati da pazienti con disturbi mendeliani sono stati utilizzati per verificare il riconoscimento di varianti patogene e il loro rapporto con la maturazione dei trascritti. Il risultato mostra che lo strumento può recuperare informazioni pertinenti alla malattia in materiale proveniente da persone reali, senza però dimostrare che un medico ottenga oggi diagnosi più accurate grazie al suo utilizzo.
Il software e alcuni dati di valutazione sono disponibili pubblicamente, mentre per i dati delle linee cellulari dei pazienti valgono restrizioni di privacy. I risultati restano legati a specifiche piattaforme e condizioni di sequenziamento, e nuove tecnologie potrebbero modificarne la prestazione. NanoTS è quindi un avanzamento di ingegneria bioinformatica con una prima verifica su campioni di malattia, non una sostituzione degli esami genetici standard già validata in clinica.
COSA SAPPIAMO
I risultati riportano F1 sopra 0,980 su dati nanopore RNA diretto e sopra 0,966 su cDNA, con almeno cinque letture di supporto. [1]
L'informazione sugli aplotipi migliora l'identificazione delle varianti quando l'espressione dei due alleli è sbilanciata.
Sono state esaminate varianti legate a disturbi mendeliani in linee cellulari di pazienti.
COSA NON SAPPIAMO
Le prestazioni non si estendono automaticamente a trascritti poco espressi o a ogni tipo di tessuto.
Non è stabilita l'accuratezza in un percorso diagnostico prospettico su pazienti non selezionati.
Punteggi su benchmark e campioni cellulari non dimostrano migliori esiti di cura.
COSA SUCCEDE ORA
Verificare la riproducibilità su piattaforme e laboratori diversi.
Confrontare le chiamate di varianti con metodi diagnostici standard nei campioni clinici.
Studiare i limiti dovuti a copertura, splicing e varianti rare.
TRACCIA DELLE FONTI
Per varianti con cinque letture di supporto, F1 superiore a 0,980 su RNA diretto e 0,966 su cDNA.
L'informazione sugli aplotipi migliora le chiamate con espressione allelica sbilanciata.
Varianti patogene mendeliane sono state esaminate in cellule di pazienti coltivate in laboratorio.
FONTI
- NanoTS: a deep learning tool for accurate SNP calling in nanopore long-read transcriptome dataApri fonte
- NanoTS: a deep learning tool for accurate SNP calling in nanopore long-read transcriptome dataApri fonte
PROVE ATTUALI
STUDIO PEER-REVIEWED
COSA CAMBIEREBBE QUESTO?
- Nuovi test indipendenti potrebbero stabilire limiti e prestazioni reali in laboratori diversi.
- Studi clinici prospettici potrebbero dimostrare un vantaggio nelle diagnosi genetiche.
- Altre tecnologie di lettura potrebbero richiedere nuove calibrazioni del metodo.