NOTIZIA IN BREVE
Il sensore MspA-FPBA combina un nanoporo di origine batterica con un adattatore chimico che reagisce temporaneamente con molecole diverse.
Ha distinto 21 aminoacidi proteinogenici, alcune varianti modificate, nucleotidi, monosaccaridi e piccoli peptidi.
Accoppiato a un modello di machine learning ha raggiunto accuratezza globale del 98,7% nei test, e ha analizzato componenti di estratti di lievito e glicopeptidi.
PERCHÉ CONTA
Molti sistemi per singola molecola riconoscono bene una specifica categoria chimica ma non passano facilmente da zuccheri a proteine o componenti dell'RNA. Un sensore capace di leggere famiglie diverse nello stesso assetto amplierebbe il tipo di analisi possibili.
Il 98,7% non è l'accuratezza di un test diagnostico sui pazienti. È il risultato di un esperimento con categorie definite e procedure di classificazione che richiedono ancora verifiche su miscele biologiche complesse.
CHE COSA È ORA POSSIBILE
Before: narrow analyte scope in a single pore. Now: amino acids, sugars, nucleotides and peptides have been physically characterized and classified in one engineered sensor.
COSA LO HA RESO POSSIBILE
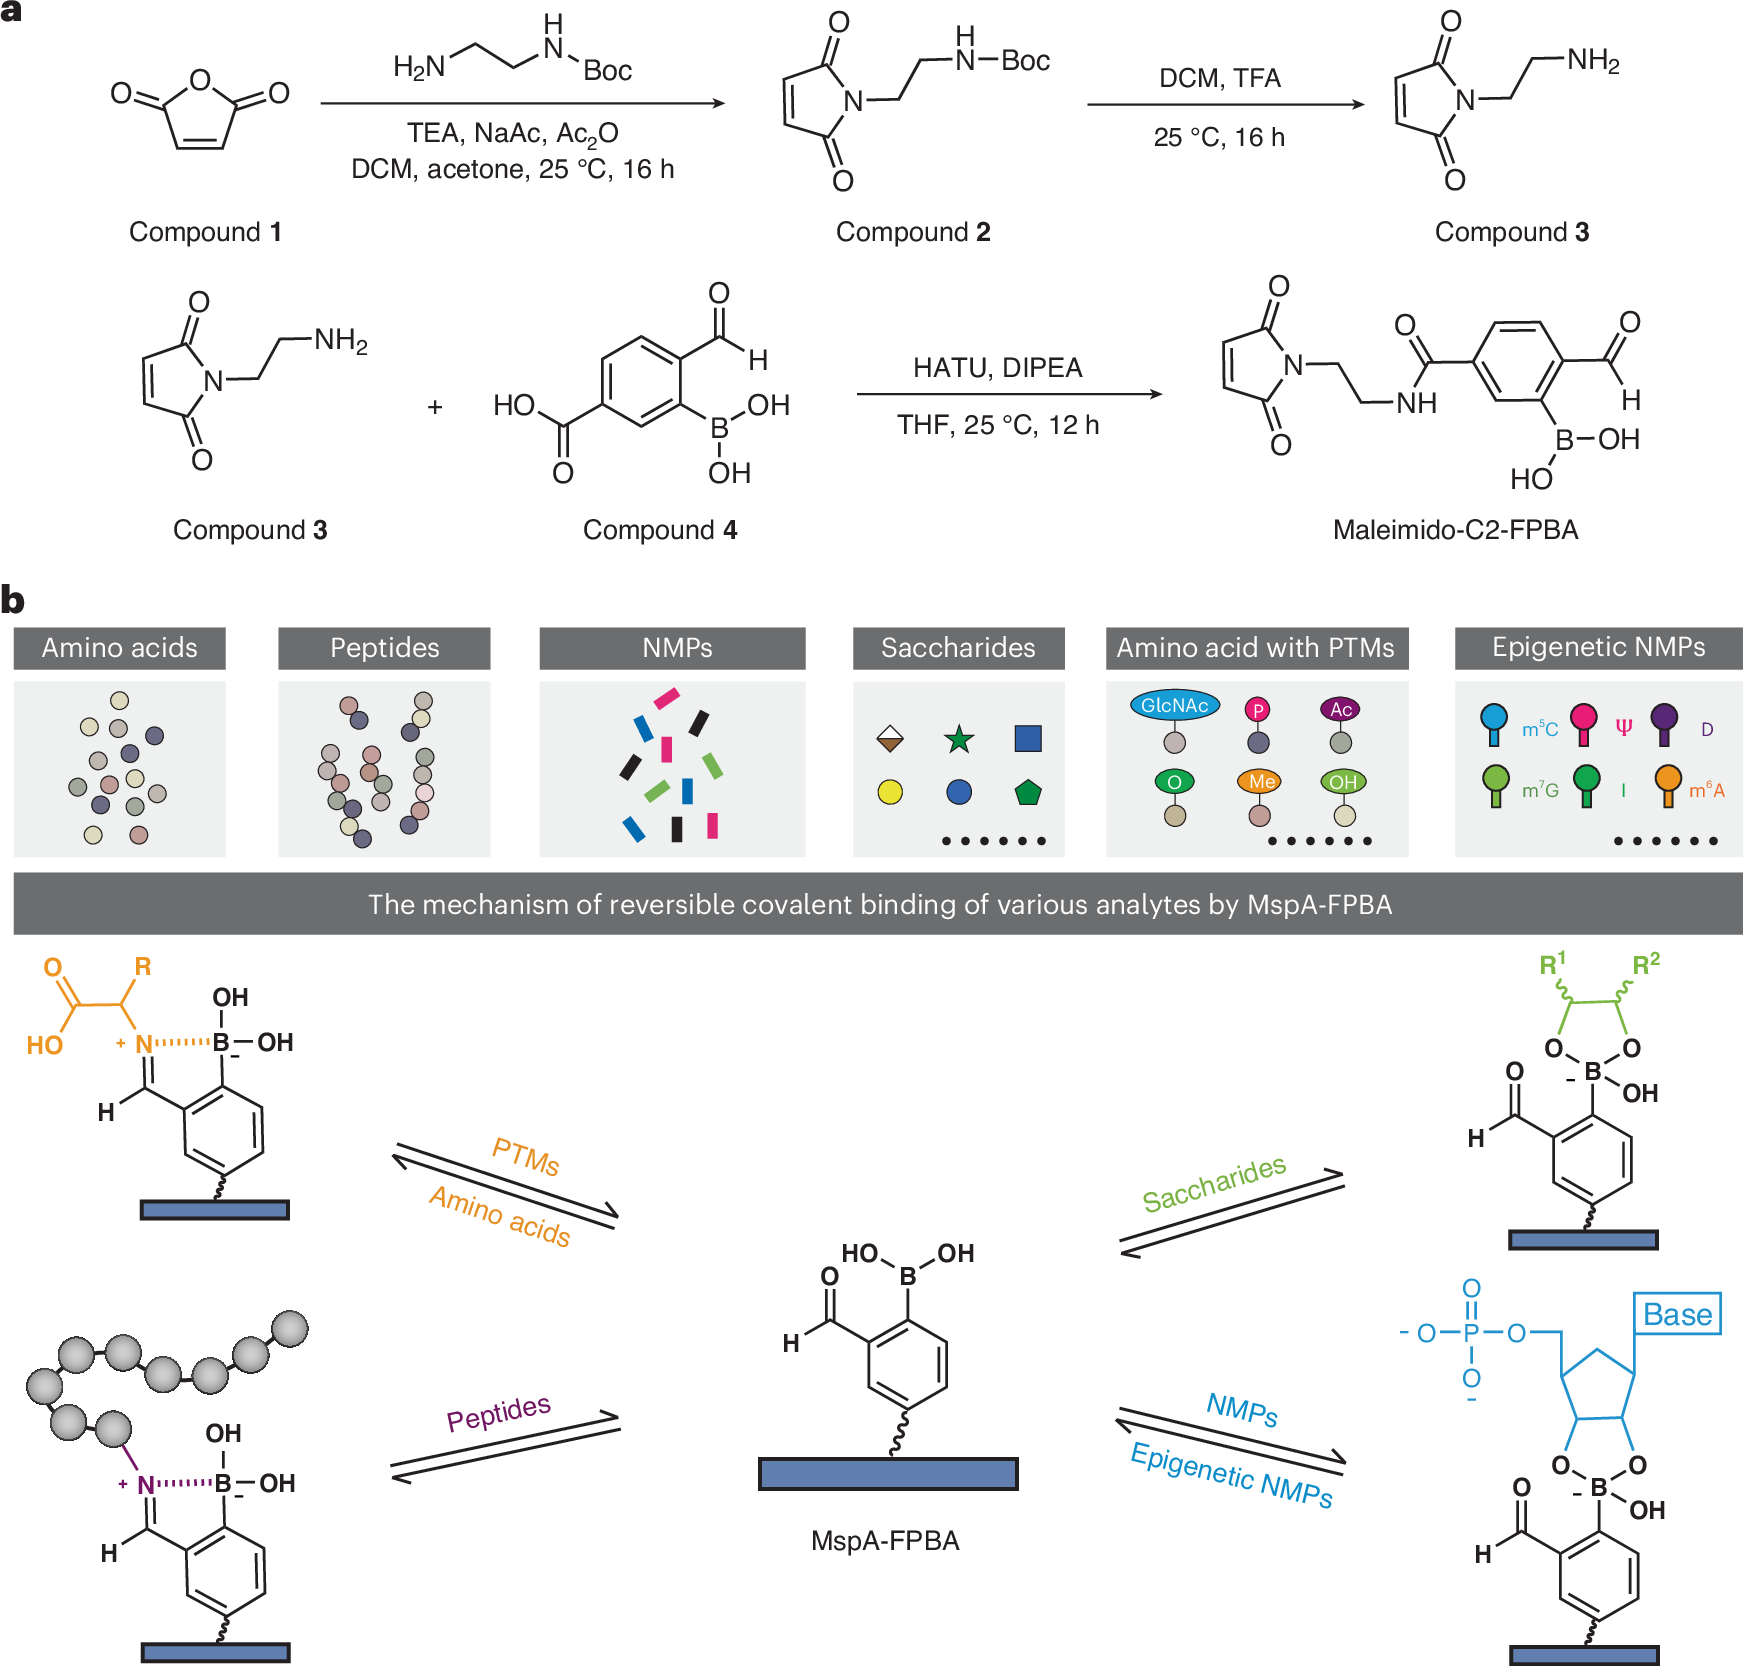
Gli autori hanno modificato il restringimento di un poro proteico MspA con un gruppo chimico maleimido-C2-FPBA, in grado di stabilire interazioni reversibili con molte molecole.
Quando ciascuna molecola occupa il poro, la corrente ionica cambia in modo caratteristico. Un algoritmo impara a distinguere la forma e la durata dei segnali.
LA STORIA
Un canale microscopico scavato in una membrana può funzionare come un lettore chimico: quando una molecola attraversa il poro, modifica per un istante la corrente elettrica. I sensori a nanoporo hanno già raggiunto ottimi risultati per alcuni composti, ma riconoscere contemporaneamente molecole molto diverse resta difficile. Un gruppo di ricerca ha realizzato MspA-FPBA, un poro ingegnerizzato che distingue zuccheri, aminoacidi, nucleotidi e peptidi con un'unica architettura. Lo studio originale è stato pubblicato su Nature Biotechnology il 14 settembre 2026.
Il punto di partenza è MspA, una proteina di membrana del batterio Mycobacterium smegmatis. Il gruppo ha collegato al suo restringimento una piccola molecola chimica, maleimido-C2-formilfenilboronico, che può interagire reversibilmente con gruppi chimici di analiti differenti. Il contatto non deve intrappolare stabilmente il campione: è sufficiente a generare una firma elettrica che può essere misurata e confrontata.
Il sistema ha identificato 21 aminoacidi proteinogenici e tre aminoacidi modificati, quattro nucleotidi monofosfato canonici e tre modificati, quattro monosaccaridi e cinque peptidi. La combinazione con machine learning ha raggiunto accuratezza complessiva del 98,7% in una valutazione controllata di classificazione. È un risultato notevole perché le molecole appartengono a famiglie con geometrie e proprietà chimiche diverse. Il numero, tuttavia, dipende da quali analiti erano inclusi e da come sono stati costruiti i test.
Gli autori hanno esplorato anche come riconoscere analiti non già presenti nella banca dei segnali di addestramento. Un approccio che sfrutta poche osservazioni iniziali ha permesso di classificare molecole nuove sulla base di caratteristiche apprese per famiglie simili. Per andare oltre gli standard purificati, il gruppo ha analizzato un estratto cellulare di lievito e ha esaminato la composizione di glicopeptidi G2, molecole nelle quali parti zuccherine sono associate a un peptide.
Questo è il passaggio che rende la ricerca più di un benchmark software: le firme sono state registrate fisicamente da singole molecole, anche in campioni biologici. Non si tratta però di un sequenziatore universale in grado di identificare qualsiasi molecola in modo completo o di un test clinico già funzionante. Per passare alle applicazioni servono automazione, controlli sulle miscele, capacità di misurare concentrazioni e procedure affidabili in laboratori indipendenti.
COSA SAPPIAMO
La modifica chimica del nanoporo MspA ha consentito il riconoscimento sperimentale di molte famiglie di analiti. [1][2]
Nei test di classificazione degli autori l'accuratezza complessiva dichiarata è stata del 98,7%.
Sono state eseguite analisi su estratti di lievito e su un glicopeptide, oltre che su standard purificati.
COSA NON SAPPIAMO
Non è dimostrato che il sensore riconosca qualunque analita in un campione non preparato.
L'accuratezza del benchmark non rappresenta le prestazioni di diagnosi di malattia.
La riproducibilità della tecnologia in piattaforme commerciali e in laboratori indipendenti resta da verificare.
COSA SUCCEDE ORA
Estendere i test a miscele più complesse e a concentrazioni variabili.
Valutare misure quantitative riproducibili e stabilità del nanoporo.
Studiare se sistemi di elaborazione e preparazione possano essere integrati in un dispositivo utilizzabile.
TRACCIA DELLE FONTI
Il nanoporo ha riconosciuto quattro famiglie di composti nei test sperimentali.
La classificazione automatica ha raggiunto accuratezza globale del 98,7% nei test.
Il sistema ha analizzato estratti di lievito e la composizione di glicopeptidi.
FONTI
- An engineered nanopore identifies saccharides, amino acids, peptides and ribonucleotidesApri fonte
- A versatile nanopore identifies four classes of analytes simultaneouslyApri fonte
PROVE ATTUALI
STUDIO PEER-REVIEWED
COSA CAMBIEREBBE QUESTO?
- Test indipendenti potrebbero confermare la capacità su campioni complessi.
- Misure ripetute di concentrazione potrebbero rendere il sistema più utile in laboratorio.
- Una piattaforma automatizzata potrebbe segnare il passaggio dall'esperimento al dispositivo.