NOTIZIA IN BREVE
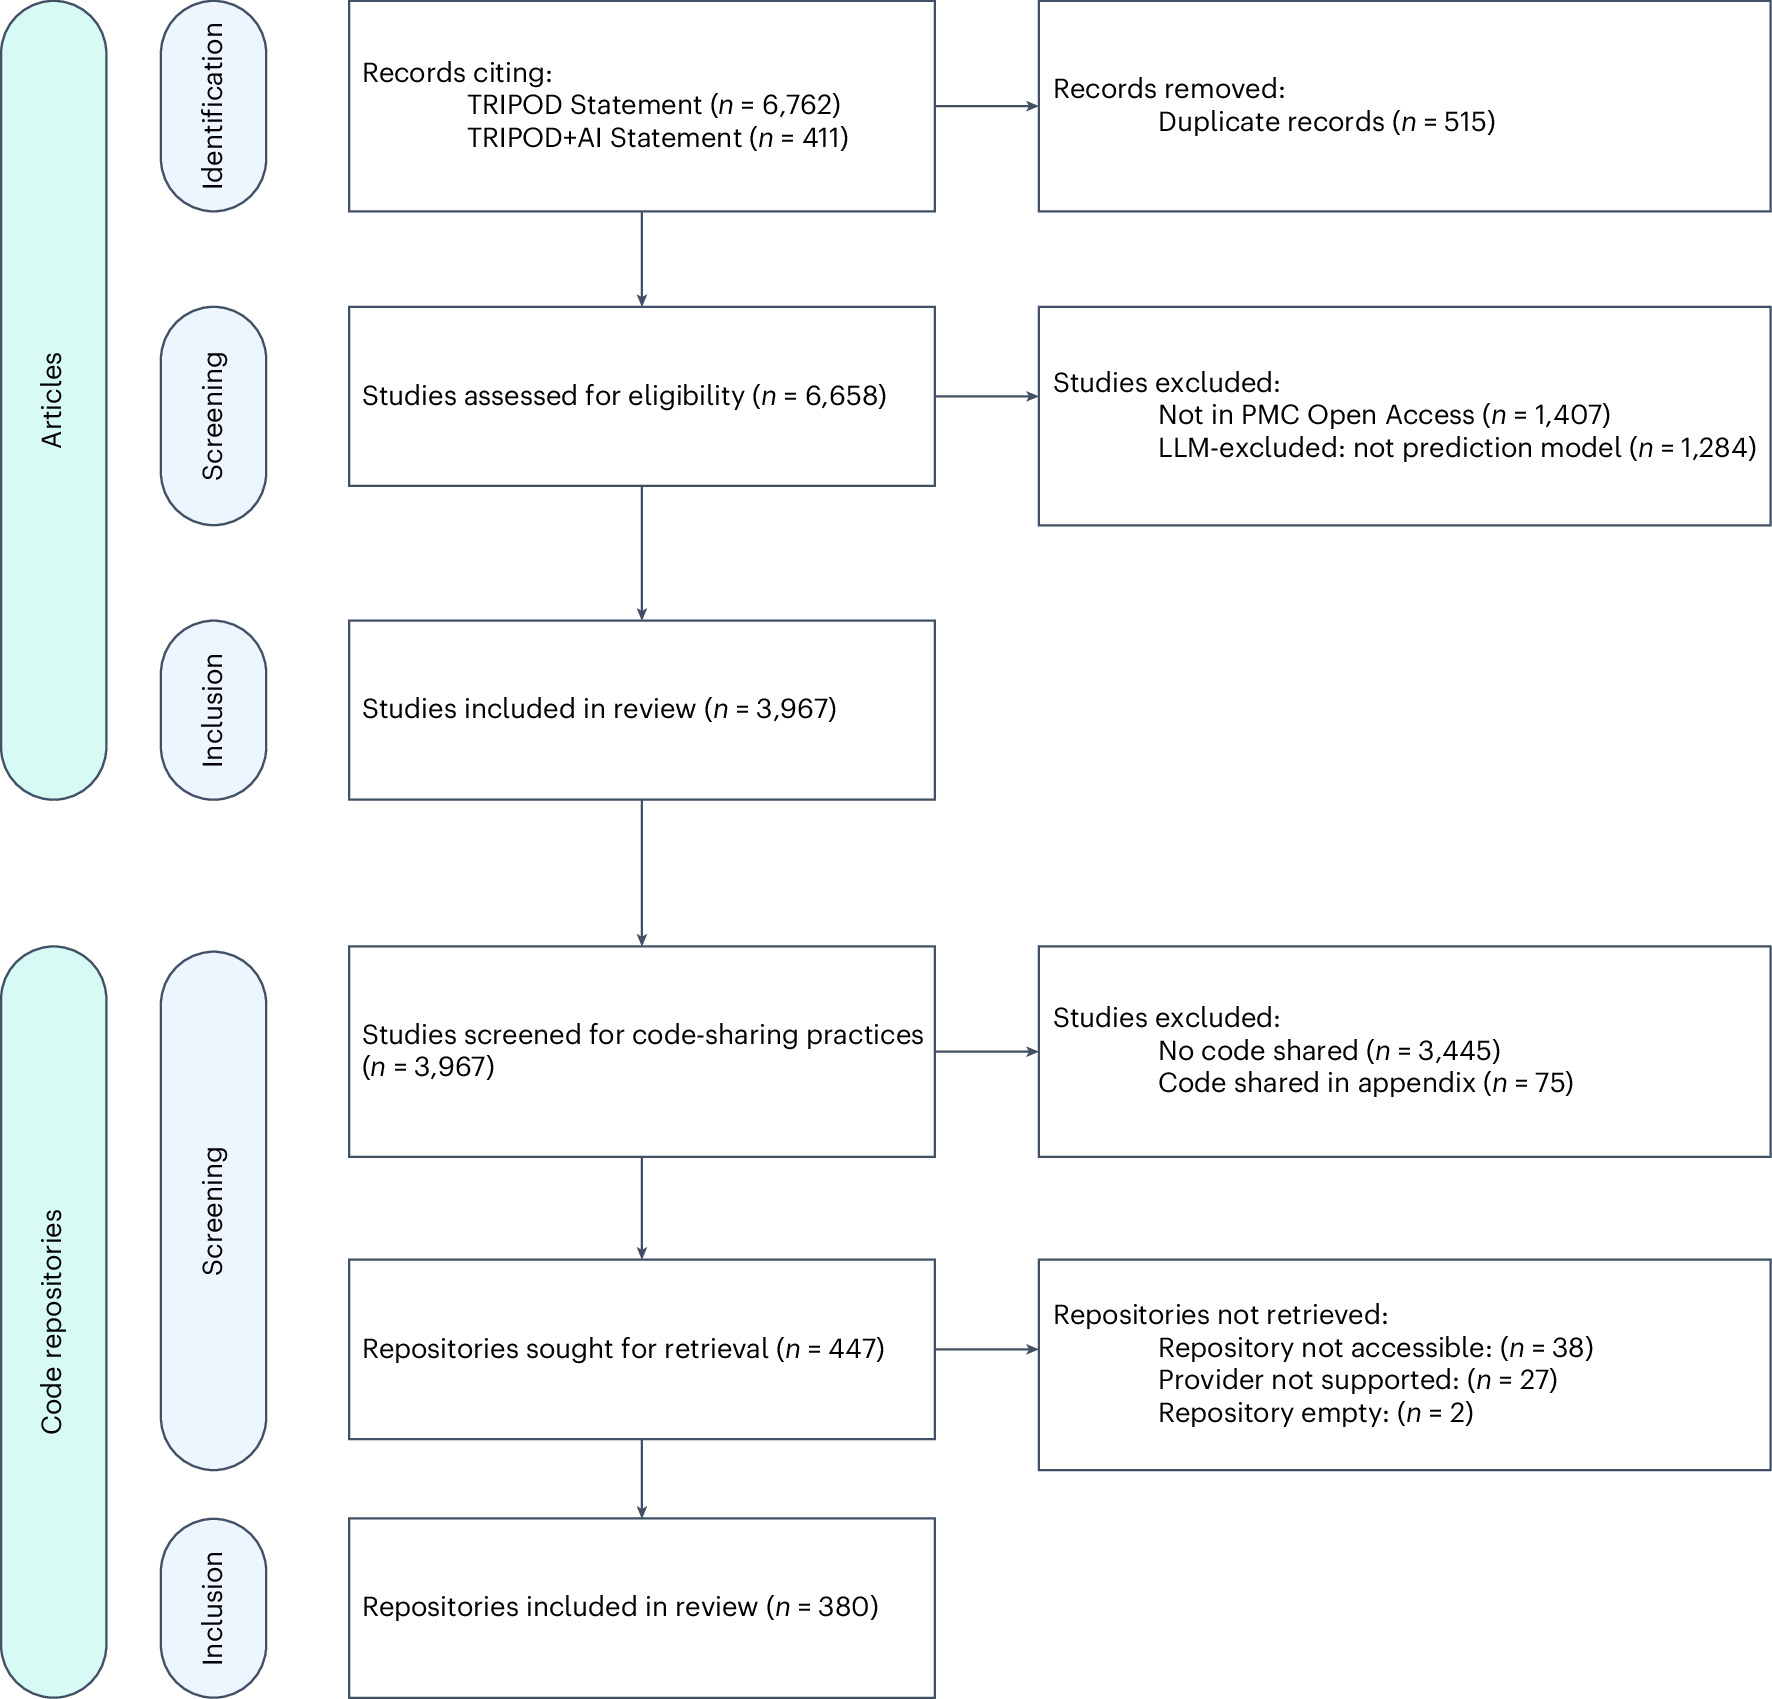
Una ricerca pubblicata su Nature Medicine il 9 ottobre 2026 ha analizzato 3.967 articoli sui modelli di previsione clinica che citavano TRIPOD o TRIPOD+AI.
Soltanto 482 (12,2%) fornivano codice; tra i 380 repository esaminati, documentazione, dipendenze e test erano spesso incompleti.
Il campione include solo articoli open access recuperabili tramite PubMed Central e non rappresenta necessariamente tutti i modelli clinici pubblicati.
PERCHÉ CONTA
I modelli che stimano il rischio di malattia o un esito clinico possono entrare in decisioni reali. Per capire se un risultato si ripete con altri dati non basta leggere una percentuale di accuratezza: occorre poter ispezionare la preparazione dei dati e il codice di analisi.
Il numero di repository non coincide con quello di strumenti realmente rieseguibili. Senza versioni dei pacchetti, istruzioni chiare e test è difficile capire se una differenza nei risultati dipenda dal modello o dall'ambiente software.
CHE COSA È ORA POSSIBILE
Before: incomplete evidence on how often clinical prediction models share usable analytical code. Now: a defined 3,967-paper review measures code availability and repository documentation gaps.
COSA LO HA RESO POSSIBILE
I ricercatori hanno usato un sistema di analisi assistito da modello linguistico per cercare dichiarazioni di disponibilità del codice negli articoli e studiare 14 caratteristiche dei repository.
Hanno confrontato il sistema con 500 articoli annotati manualmente; è un controllo importante, ma la classificazione automatica non è perfetta.
LA STORIA
Quanto è facile controllare i calcoli alla base di un modello che prevede la diagnosi o la prognosi di un paziente? Un gruppo internazionale ha esaminato 3.967 articoli scientifici e ha trovato codice condiviso in 482, pari al 12,2%. Lo studio, pubblicato su Nature Medicine il 9 ottobre 2026, descrive una lacuna di trasparenza in un settore dove la riproducibilità serve a valutare affidabilità e trasferibilità dei modelli.
Gli articoli non erano una selezione casuale di tutta la letteratura. Il gruppo ha cercato lavori che citavano le linee guida TRIPOD o TRIPOD+AI e sviluppavano, validavano o aggiornavano modelli predittivi multivariabili. Per l'analisi erano necessari testi open access recuperabili da PubMed Central. Proprio questa scelta può favorire studi più attenti alla rendicontazione e dunque sovrastimare la diffusione del codice condiviso rispetto all'intero settore.
Il 12,2% è la quota degli studi inclusi che condividevano codice attraverso repository o materiali allegati. I ricercatori hanno poi analizzato 380 repository accessibili, controllando caratteristiche utili per ripetere un esperimento computazionale. Solo una parte specificava chiaramente le dipendenze software, ancora meno riportava versioni vincolate o test automatici. Rendere un link disponibile, insomma, non garantisce che un altro gruppo possa avviare lo stesso programma e ottenere lo stesso risultato.
La metodologia ha un secondo aspetto: un modello linguistico ha aiutato a filtrare migliaia di articoli e a recuperare riferimenti al codice. Gli autori hanno valutato il sistema su 500 articoli annotati da persone, ottenendo un punteggio F1 ponderato di 0,97 per la selezione e accuratezza del 92,3% nel recupero dei collegamenti ai repository. Rimangono possibili errori di classificazione, quindi le percentuali descrivono una tendenza più che un censimento infallibile.
Le pratiche sono migliorate nel tempo: nella coorte studiata la quota con codice condiviso era del 14,5% nel 2024 e del 15,8% nel 2025. I lavori che citavano TRIPOD+AI avevano una frequenza maggiore rispetto a quelli che citavano TRIPOD, ma la relazione osservata non dimostra che la linea guida abbia causato il miglioramento. Il risultato mette a disposizione un punto di partenza per TRIPOD-Code, una guida in preparazione. Non certifica che i modelli senza codice siano clinicamente sbagliati: mostra che la verifica indipendente è più difficile.
COSA SAPPIAMO
482 dei 3.967 articoli selezionati condividevano codice, il 12,2% del campione. [1]
I repository accessibili differivano notevolmente per presenza di dipendenze, licenze, documentazione e test.
Lo studio ha confrontato lo screening automatizzato con un campione di 500 articoli valutati da revisori umani.
COSA NON SAPPIAMO
La percentuale non è rappresentativa di tutti gli studi clinici o di tutta l'AI in sanità.
Il codice non condiviso non equivale automaticamente a un modello diagnostico scorretto.
L'accessibilità del repository non dimostra che ogni analisi possa essere rieseguita con successo.
COSA SUCCEDE ORA
Definire requisiti minimi per documentare dipendenze, versioni, licenze e procedure di esecuzione.
Valutare se l'adozione della futura guida TRIPOD-Code migliorerà davvero riproducibilità e controllo.
Replicare l'analisi su altri gruppi di studi e verificare direttamente l'eseguibilità del codice.
TRACCIA DELLE FONTI
482 dei 3.967 articoli selezionati condividevano codice (12,2%).
Gli autori hanno caratterizzato 380 repository accessibili.
Lo screening automatizzato è stato confrontato con 500 valutazioni manuali, F1 ponderato 0,97.
Il campione limitato a studi open access che citano TRIPOD non rappresenta tutta la letteratura.
FONTI
- AI-assisted scoping review of code sharing in clinical prediction model researchApri fonte
- AI-assisted scoping review of code sharing in clinical prediction model researchApri fonte
PROVE ATTUALI
STUDIO PEER-REVIEWED
COSA CAMBIEREBBE QUESTO?
- Revisioni manuali più estese potrebbero correggere errori di classificazione.
- Studi su riviste e campioni non TRIPOD chiarirebbero la generalizzabilità.
- Test diretti di esecuzione distinguerebbero il codice accessibile da quello riproducibile.